Stemmekloning kan nå kopiere en persons stemme basert på bare noen få lydopptak. Norsk er et lite språk med et enormt mangfold av dialekter, så det er fristende å tro at vi derfor har en ekstra beskyttelse mot stemmekloningsangrep. Vi bestemte oss for å teste denne antakelsen: 130 SINTEF-ansatte lyttet til ekte og KI-generert norsk tale og skulle avgjøre hva som var hva. Resultatene tyder på at vi kanskje ikke kan stole helt på at dialektene våre beskytter oss.
Vi ba Viggo Tellefsen Wivestad, som ledet forskningen, forklare hva de gjorde, hva de fant, og hva resultatene kan bety.
Hvorfor er stemmekloning en stadig større sikkerhetsutfordring?
Det er flere grunner til det. Teknologien har blitt svært kraftig, den er pakket inn i brukervennlige verktøy, og den er lett tilgjengelig. Dette gjør det enklere for ondsinnede aktører å lure oss, noe vi allerede har sett tilfeller av.
En sak som fikk stor oppmerksomhet var robocall-angrepet i USA, der en klonet versjon av Joe Bidens stemme fortalte velgere at det ikke var viktig å stemme ved et suppleringsvalg. Deretter kom saken i Hongkong, hvor lyd- og videobaserte deepfakes ble kombinert og brukt direkte i et videomøte for å svindle et selskap for rundt 25 millioner amerikanske dollar. Tidligere måtte de mest overbevisende deepfake-opptakene produseres på forhånd. At angrepet kunne gjennomføres «live» viste hvor langt teknologien hadde kommet.
Vi har også sett lignende hendelser i Norge. Blant annet ble DNB utsatt for et sofistikert forsøk der en deepfake-versjon av bankens finansdirektør forsøkte å instruere ansatte ved Singapore-kontoret om å utbetale millioner av singapore-dollar under et faktisk Teams-møte.
Selv om teknologien er skummel, må det også nevnes at den i noen tilfelles har gode og legitime bruksområder. Ett eksempel er personer som står i fare for å miste stemmen på grunn av sykdom, og som kan bevare sin egen stemme i stedet for å måtte bruke en syntetisk robotstemme. Men det er rimelig å spørre om denne gevinsten veier opp for en verden der hvem som helst kan få hvem som helst til å høres ut som de sier hva som helst.
Hvorfor studerte dere norsk spesielt?
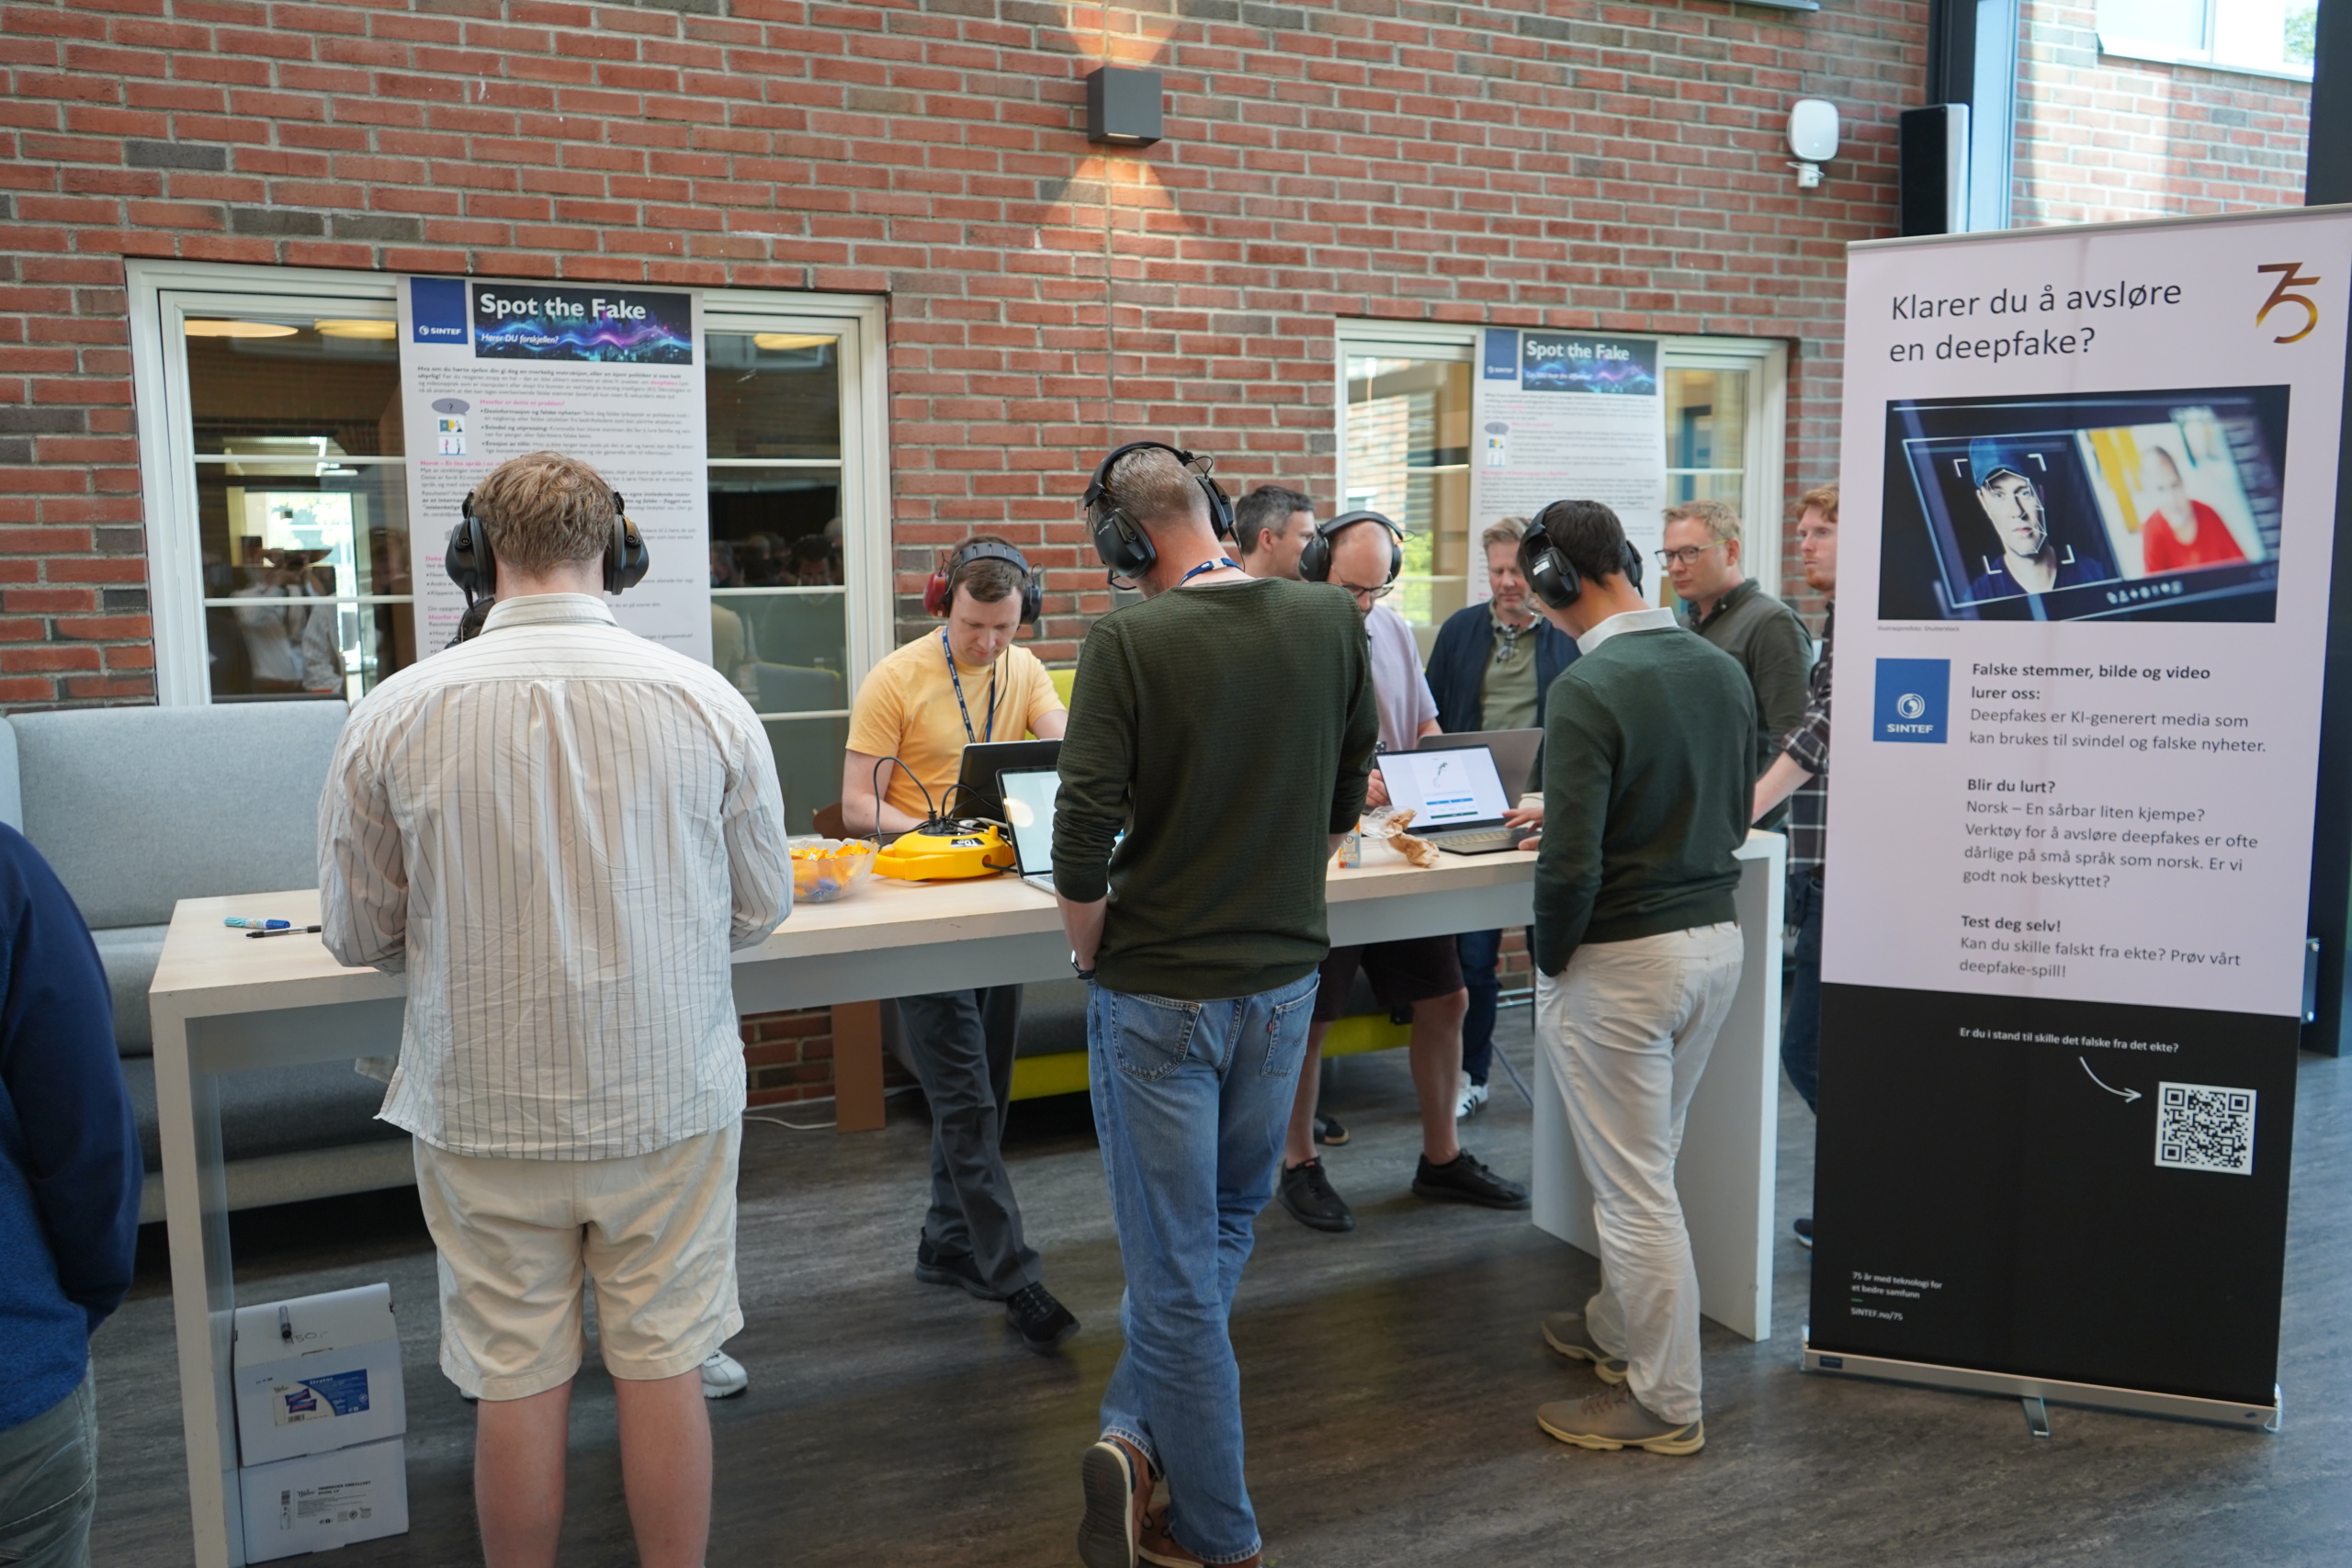
Vi hadde brukt et par år på å utforske deepfakes på tvers av ulike medietyper. Vi utviklet spillet Spot the Fake, der brukerne skal gjette om bilder, tale, sanger og videoer er ekte eller kunstig generert.
Mens vi utviklet spillet, innså vi hvor moden lydteknologien hadde blitt. Kommersielle og brukervennlige verktøy for stemmekloning hadde på det tidspunktet få begrensninger, og resultatene var langt mer overbevisende enn bildene, der man fortsatt kunne avsløre kunstige motiver ved å se etter klassiske feil, som hender med seks fingre.
Dette gjorde oss nysgjerrige på norsk, fordi det fantes to konkurrerende hypoteser. Den mest intuitive er at norsk er et minoritetsspråk som trolig er underrepresentert i treningsdataene, og at KI derfor burde prestere dårligere. Den motsatte hypotesen er at brukere av små språk kan være mer sårbare fordi taleteknologien tradisjonelt har vært ganske dårlig for de mindre språkene, og mange har derfor et utdatert bilde av hvordan en datagenerert stemme høres ut. Hvis referansepunktet ditt er de robotaktige stemmene fra noen år tilbake, trenger ikke en moderne stemmeklon å være perfekt for å virke troverdig.
Norsk har også stor dialektvariasjon og ingen universelt etablert talemålsstandard. Dette reiste derfor et nytt spørsmål: Gjør dialektmangfold det lettere å oppdage syntetisk tale?
Hva vet vi allerede om evnen vår til å oppdage syntetiske stemmer?
At den er ganske begrenset.
Kontrollerte studier på engelsk, mandarin og andre språk viser at folk bare gjør det noe bedre enn ren gjetning, selv i settinger hvor de vet at det finnes falske eksempler i materialet. Men resultatene er langt fra pålitelige. Noen studier beskriver prestasjoner tilnærmet et myntkast.
Resultatene avhenger også av konteksten, og de fleste eksperimentene har brukt forhåndsinnspilte lydklipp. Å generere en realistisk, forfalsket stemme i sanntid er sannsynligvis betydelig vanskeligere.
Programvare for deepfake-deteksjon er en del av løsningen, men dette er et kontinuerlig kappløp mellom angripere og forsvarere. På sikt kan vi få falske stemmer som er nær virkeligheten at de blir umulige å skille fra ekte opptak. Derfor trenger vi også andre verktøy, både tekniske løsninger for autentisering og sosiale mekanismer som styrker menneskers vurderingsevne.
Hvordan gjennomførte dere testen?
Vi brukte taleopptak fra Nasjonalbibliotekets talekorpus, NB Tale. Her har hundrevis av personer fra hele landet lest inn de samme setningene. Dette var ideelt fordi vi ikke ønsket at innholdet i setningene skulle påvirke hvor realistiske de virket.
Vi valgte ut 20 personer fra ti dialektområder, med jevn fordeling mellom kvinner og menn. Alle var 40 år eller eldre, siden vi antok at de i større grad ville ha tradisjonelle dialekttrekk.
For hver person beholdt vi to opptak som et hemmelig testsett og brukte de resterende 18 opptakene til å klone stemmen med ElevenLabs, et ledende kommersielt verktøy. Deretter lot vi stemmeklonen lese de to skjulte setningene. Hvert lydklipp ble generert én gang, og vi brukte det første resultatet, slik en utenlandsk angriper uten norskkunnskaper sannsynligvis ville gjort.
Dialektområdene ble gruppert i fem større regioner: Nord, Midt, Vest, Øst og Sør. Hver deltaker lyttet til 20 lydklipp i tilfeldig rekkefølge, hvorav ti var ekte og ti var syntetiske. Samtidig fikk de se et kart som viste hvor taleren kom fra. For hvert klipp skulle de avgjøre om stemmen var ekte eller KI-generert.
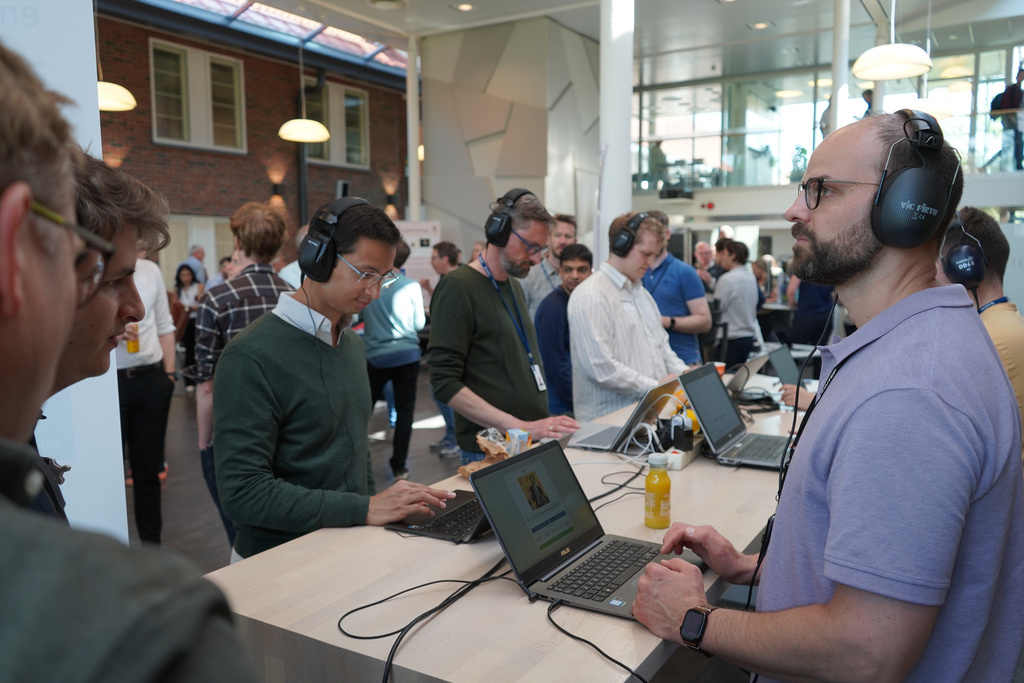
Alle deltakerne fikk beskjed på forhånd om at deepfakes inngikk i materialet. Under jubileumsarrangementet satt de ved seks bærbare PC-er med støydempende hodetelefoner av høy kvalitet.
Hvor flinke var folk til å oppdage de falske stemmene?
Ikke spesielt flinke.
De 130 deltakerne vurderte 31,3 prosent av de KI-genererte opptakene som ekte. Med andre ord passerte omtrent én av tre falske stemmer som menneskelig.
Den totale treffsikkerheten var 69,8 prosent. Deltakerne identifiserte 68,7 prosent av de falske opptakene korrekt, men de stemplet også 28,9 prosent av de ekte opptakene feilaktig som KI-genererte.
Dette skjedde selv om deltakerne var høyt utdannede, teknologivante, hadde fått forhåndsvarsel og var motiverte for å lykkes. Virkelige ofre for svindel får sjelden slike fordeler.
Hadde det betydning om lytteren hadde norsk som morsmål?
Ja.
SINTEF har ansatte fra mer enn 80 nasjonaliteter, så vi forventet forskjeller, og vi fant dem.
Personer med norsk som morsmål ble lurt i 27,1 prosent av tilfellene, mens andelen blant ikke-norskspråklige var 41,3 prosent. Det tilsvarer en forskjell på omtrent 14 prosentpoeng.
Forskjellen skyldtes ikke bare at de ikke-norskspråklige deltakerne var mer tillitsfulle. De var generelt dårligere til å skille ekte fra kunstig tale og gjorde flere feil begge veier: De overså flere falske stemmer og mistenkte flere ekte stemmer for å være KI-genererte.
Å kjenne språket og språkets rytme og melodi gir altså en viss beskyttelse. Samtidig ble også morsmålsbrukerne lurt mer enn én av fire ganger.
Var noen dialekter lettere å etterligne enn andre?
Dette var kanskje den største overraskelsen.
Blant deltakere med norsk som morsmål ble følgende andel av de falske opptakene vurdert som ekte:
- Sør: 56,6 %
- Øst: 46,4 %
- Nord: 22,5 %
- Vest: 15,7 %
- Midt: 10,2 %
Sørlandske og østnorske stemmer lurte folk oftest. Nordnorske stemmer ga best mulighet til å skille mellom ekte og falskt, etterfulgt av vestnorske.
Resultatet for Midt-Norge var særlig interessant. Siden eksperimentet ble gjennomført i Trondheim, forventet vi at den lokale «hjemmepublikummet» ville prestere godt. I stedet viste de en stor skepsis mot stemmer fra Midt-Norge og merket mange av dem som kunstige, enten de faktisk var det eller ikke.
Deres lave mottakelighet for å bli lurt skyldtes altså ikke bedre deteksjonsevne. Det handlet om en skjevhet: De trodde rett og slett ikke at folk faktisk snakket slik. Dette viser at det å være skeptisk ikke nødvendigvis er det samme som å være flink til å oppdage deepfakes.
Vi tror også at noen av mønstrene kan skyldes selve klonene. Etter eksperimentet oppdaget vi at enkelte nordnorske stemmekloner hørtes mer øst- eller sørnorske ut enn nordnorske. Fordi deltakerne kunne se hvor taleren kom fra, kan noen ha avslørt dem som falske fordi dialekten virket «feil», ikke fordi stemmen hørtes kunstig ut.
Hvis det stemmer, kan kjennskap til en dialekt gi en viss beskyttelse, men bare dersom stemmekloningsverktøyet klarer å gjenskape dialekten korrekt.
Hva er begrensningene ved studien?
Det er flere.
Alle deltakerne var SINTEF-ansatte som selv valgte å delta. Utvalget er derfor ikke representativt for Norges befolkning.
Noen regioner var representert av bare to til seks klonede stemmer, noe som gjør resultatene usikre og skjuler variasjon innenfor hver region.
Vi testet bare ett kommersielt verktøy og brukte korte innleste opptak, ikke reelle telefonsamtaler eller naturlige samtaler. Lydklippene var også forhåndsinnspilt og ikke generert i sanntid.
Dette er derfor foreløpige resultater, ikke et endelig svar. Likevel peker funnene i samme retning som annen forskning.
Så, beskytter dialektmangfoldet oss?
Bare til en viss grad.
Dialektmangfold og det å snakke et lite språk ser ikke ut til å være et sterkt, naturlig forsvar mot stemmebasert deepfake-svindel. Lytterne beholdt en viss evne til å skille ekte fra falskt, men resultatene varierte med både språkkompetanse og dialekt, og ble påvirket av forventninger så vel som av det de faktisk hørte.
Hva kan beskytte oss da? Mer skepsis?
Til en viss grad, men for mye skepsis er heller ikke bra.
Som de ikke-norskspråklige deltakerne viste, fører økt mistro ofte bare til at problemet flytter seg: Man avviser flere ekte personer. Menneskelig dømmekraft alene bør derfor ikke være vår viktigste beskyttelse mot deepfake-svindel.
Det finnes tekniske løsninger, som verktøy for deepfake-deteksjon og metoder som dokumenterer at innhold er autentisk, for eksempel C2PA-standarden og ulike former for digital vannmerking.
Men i praksis er løsningen ofte manuell og menneskesentrert. Hvis et forsikringsselskap mistenker at et skadebilde er manipulert, kan de ringe kunden, stille oppfølgingsspørsmål, be om flere bilder eller inspisere bilen fysisk. Dette krever ressurser, men det fungerer.
Vi trenger også institusjoner som kan hjelpe oss å avgjøre hva som er sant. Her vil journalister, mediehus og offentlige myndigheter få en enda viktigere rolle fremover.
Hva er det mest relevante neste steget for denne forskningen?
Studien har allerede ført til nye samarbeid.
Sammen med Norwegian Centre for Trustworthy AI (Trust) undersøker vi hvordan deepfakes påvirker sentrale norske aktører som politiet, domstolene, banksektoren og forsikringsbransjen.
Fremtidige studier av stemmebaserte deepfakes bør omfatte flere dialekter, flere talere og flere stemmekloningssystemer. De bør også undersøke hvordan folk håndterer falske stemmer i levende samtaler og sanntidsangrep.
Studien «Does Dialect Diversity Protect Against Deepfake Vishing? Evidence from a Norwegian Listening Experiment» av Viggo Tellefsen Wivestad, Per Håkon Meland, Tron Vedul Tronstad, Femke B. Gelderblom og Marte Høiby ble presentert på NordSec 2026, den nordiske konferansen for sikre IT-systemer. Arbeidet ble delvis finansiert av Norges forskningsråd gjennom prosjektet AI-mar.


Kommentarer
Ingen kommentarer enda. Vær den første til å kommentere!